Réseau décentralisé ou distribué
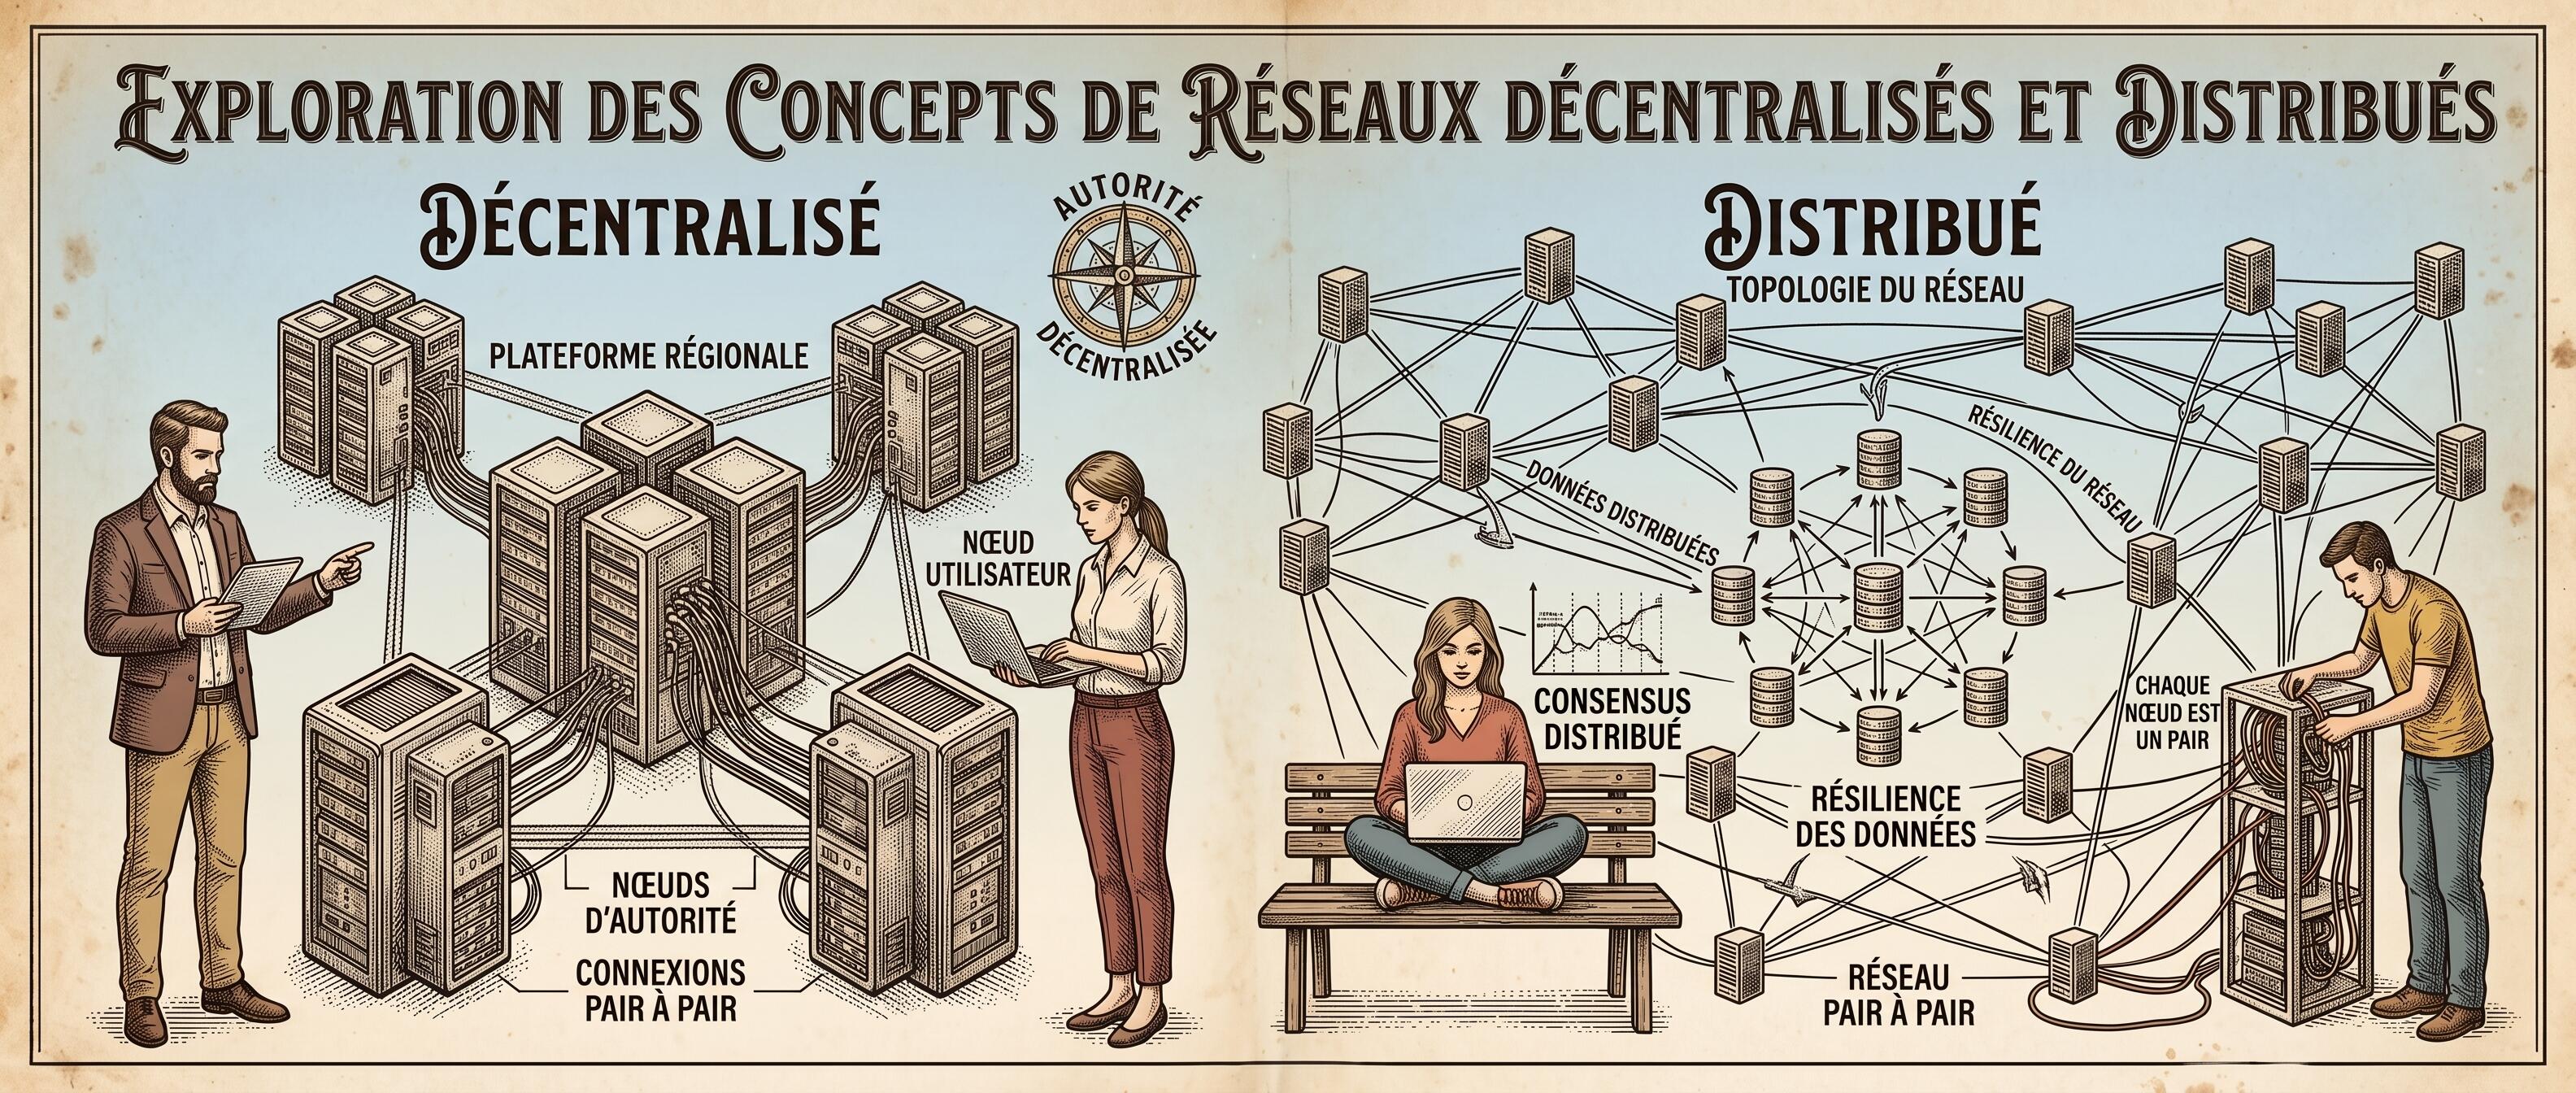
Au travers de nos précédents articles, nous avons exploré en filigrane deux aspects de la souveraineté : la décentralisation et la distribution.
Ces concepts guident chacun différents aspects des technologies que nous employons au quotidien, et pas seulement de Bitcoin. La notion de décentralisation porte sur la responsabilité des ressources et de leur traitement, tandis qu’un réseau distribué est un réseau où les données sont effectivement traitées par les différents nœuds du réseau.
Nous allons le voir, ces concepts sont loin d’être binaires.
Décentralisation des responsabilités
Aucun nœud (ni groupe restreint de nœuds) ne détient une autorité exclusive sur le système. Les décisions – validation des données, droit d’accès, évolution des règles – sont prises collectivement ou localement. C’est l’aspect gouvernance et pouvoir.
Du responsable unique au quorum
Dans la plupart des systèmes que nous utilisons au quotidien, un seul responsable décide.
Prenons l’exemple des bases de données classiques. Avec MySQL ou PostgreSQL en configuration simple, nous trouvons un nœud primaire (le « maître ») et des nœuds secondaires qui se contentent de recopier ses données. Le maître est le seul à accepter les écritures. S’il tombe, le système devient souvent indisponible, même si les copies existent ailleurs. Nous avons de la redondance, mais l’autorité reste concentrée.
Pour réduire ce risque, nous pouvons mettre en place un système à plusieurs maîtres, ou utiliser des algorithmes de consensus comme Raft ou Paxos (le premier privilégie la simplicité là où le second est plus général mais plus complexe). Pour ces deux algorithmes, un petit groupe de serveurs se mettent d’accord entre eux – suivant des règles établies par l’algorithme – avant d’accepter une modification. Plus aucun serveur n’est seul décideur. Pourtant, l’autorité reste limitée à ce cercle fermé de machines choisies à l’avance. Nous sortons du modèle « un seul responsable », mais nous n’avons pas encore une décentralisation ouverte.
51% responsable
Bitcoin pousse la logique plus loin. Le problème qu’il résout ressemble à celui des bases de données : lorsque deux versions concurrentes d’une même information apparaissent – ici une transaction en Bitcoin – laquelle fait foi ? Bitcoin répond par la preuve de travail et la règle de la chaîne la plus longue, c’est-à-dire celle qui a nécessité le plus de calcul.
Ici, aucun groupe de nœuds n’est désigné à l’avance pour trancher. N’importe qui peut participer en apportant de la puissance de calcul (le traitement nécessaire pour valider la transaction). C’est l’ensemble du réseau qui, collectivement, fait autorité. Il faudrait donc contrôler au moins 50% de la puissance de calcul totale du réseau pour imposer sa version… C’est ce que nous appelons l’attaque des 51 %.
Bien entendu, c’est « presque » totalement décentralisé, car techniquement, ceux disposant de plus de moyens de calcul ont plus de poids sur les décisions. Mais c’est aujourd’hui la forme la plus poussée de décentralisation de la responsabilité, dès lors que nous plaçons la souveraineté individuelle et la résistance à long terme au premier plan.
Données distribuées
La charge de travail – en y incluant les traitements et le stockage des données – est répartie sur plusieurs nœuds indépendants. Le but est de réduire au minimum les points uniques de défaillance technique. Nous sommes donc sur les aspects topologiques (le lieu…) et opérationnels (… de l’action).
Du stockage réparti…
Pour comprendre les enjeux du stockage distribué, nous pouvons partir d’un exemple relativement simple et familier : le RAID, utilisé depuis longtemps dans les NAS grand public. L’idée de base est de répartir les données sur plusieurs disques durs. Dans certains cas, nous nous contentons de les découper et de les étaler, ce qui accélère les lectures et écritures, mais rend le système fragile, car si un disque tombe, tout est perdu. Dans d’autres configurations, plus abouties, nous ajoutons de la redondance : chaque information est copiée ou protégée par des données de parité (une portion de donnée différente est dupliquée), de sorte qu’un disque défaillant peut être remplacé sans perte : la donnée peut être reconstituée en combinant les fragments depuis les autres disques.
Ces mécanismes (qui définissent en bonne partie les NAS) montrent déjà deux objectifs distincts du stockage distribué : répartir la charge pour gagner en performance, et assurer une certaine résilience face aux pannes. Ils restent cependant limités à un cercle fermé de machines, souvent sous le contrôle d’un même administrateur.
… Au stockage distribué
IPFS est un réseau distribué qui pousse la logique beaucoup plus loin. Au lieu de s’appuyer sur un serveur ou un groupe de serveurs connus, ce système découpe les fichiers en fragments et les adresse par leur contenu. N’importe quel nœud du réseau peut stocker et servir ces morceaux. En théorie, plus un fichier est demandé, plus il se trouve répliqué spontanément. C’est une forme de stockage véritablement distribué, sans point central.
En pratique, cependant, la disponibilité d’un fichier dépend entièrement des nœuds qui acceptent de le conserver. Si personne ne le « pin » (c’est-à-dire ne s’engage à le garder), il peut disparaître. IPFS résout donc élégamment la question de la distribution, mais laisse ouverte celle de la pérennité et de la motivation des participants à maintenir les données dans le temps.
Traitements distribués
Les traitements distribués permettent de répartir la charge du traitement sur l’ensemble d’un réseau. Par exemple, lorsque nous déposons un fichier volumineux sur Google Drive, le service ne le confie pas à une seule machine. Il le découpe et le traite en parallèle sur plusieurs serveurs, ce qui accélère l’envoi et l’obtention du rendu.
À plus grande échelle, des systèmes comme MapReduce fonctionnent sur le même principe. Ils découpent une tâche complexe (par exemple analyser des millions de lignes de données) en petites portions indépendantes, les distribuent à de nombreuses machines, puis rassemblent les résultats. Ainsi, ce qui prendrait des heures sur un seul ordinateur peut être accompli en quelques minutes grâce à la collaboration de centaines ou de milliers de machines.
Cependant, ces technologies soulèvent un problème, car si les données restent en clair sur le réseau, n’importe qui peut y accéder. Par exemple, Bitcoin garantit l’origine grâce à la signature des transactions, comme nous l’avons vu dans nos précédents articles. Par contre, elles restent ensuite publiques justement pour garantir la qualité des transactions.
Isoler les traitements : du réseau aux processeurs
Dans le domaine du Cloud, nous déployons déjà des solutions partant des réseaux virtuels privés que nous avons eu l’occasion d’aborder dans notre série sur le Cloud. Cependant, ce genre de sécurité ne suffit pas, car nous devons garantir l’isolation jusqu’au niveau du matériel sur lequel sont exécutés les processus.
Même si un logiciel est bien protégé, même si le réseau est isolé, une faiblesse au niveau du processeur peut permettre à un programme malveillant d’accéder à des données qui ne lui sont pas destinées, simplement parce que le processeur est parfois partagé entre plusieurs clients… Le matériel lui-même doit être isolé.
C’est précisément ce que cherchent à faire les enclaves numériques. Elles créent une zone protégée à l’intérieur du processeur, où les données et les calculs sensibles restent inaccessibles au reste de la machine — y compris au système d’exploitation ou à l’administrateur d’un serveur distant. L’idée est de pouvoir confier un traitement à une machine partagée sans lui livrer entièrement ses secrets. Ainsi, Cloud et traitement distribué sont possibles sans que le partage des ressources ne soit un problème.
Vers l’autonomie numérique
Le distribué relève de la topologie technique : il permet de répartir charge, données et traitements pour gagner en résilience et en performance. Le décentralisé relève de la gouvernance : il empêche qu’un acteur unique (entreprise, État, ou petit groupe) puisse imposer sa volonté ou couper l’accès.
La souveraineté exige les deux, car elle vise l’autonomie réelle de l’utilisateur sur ses clés, ses données et le traitement de ses données. La panacée fournissant la synthèse de ces deux mondes réside dans les technologies pair à pair et les modèles que nous appelons « Local-First ». Ceux-ci mériteraient un article à eux seuls, mais nous parlons ici de traitements résidant par défaut chez l’utilisateur, avant de communiquer via un réseau en pair à pair.
L’autonomie complète suppose néanmoins un dernier levier, car si les développeurs (propriétaires du code) ou les propriétaires du réseau sont pris pour cible, une solution propriétaire peut être mise à mal… Ce qui nous ramène à l’importance d’un projet libre (ou au moins open source) : la dernière vulnérabilité est d’autant plus atténuée que notre application est répliquée à travers Internet, et n’importe qui peut y contribuer.
Write a comment