La résilience à l'ère de l'information
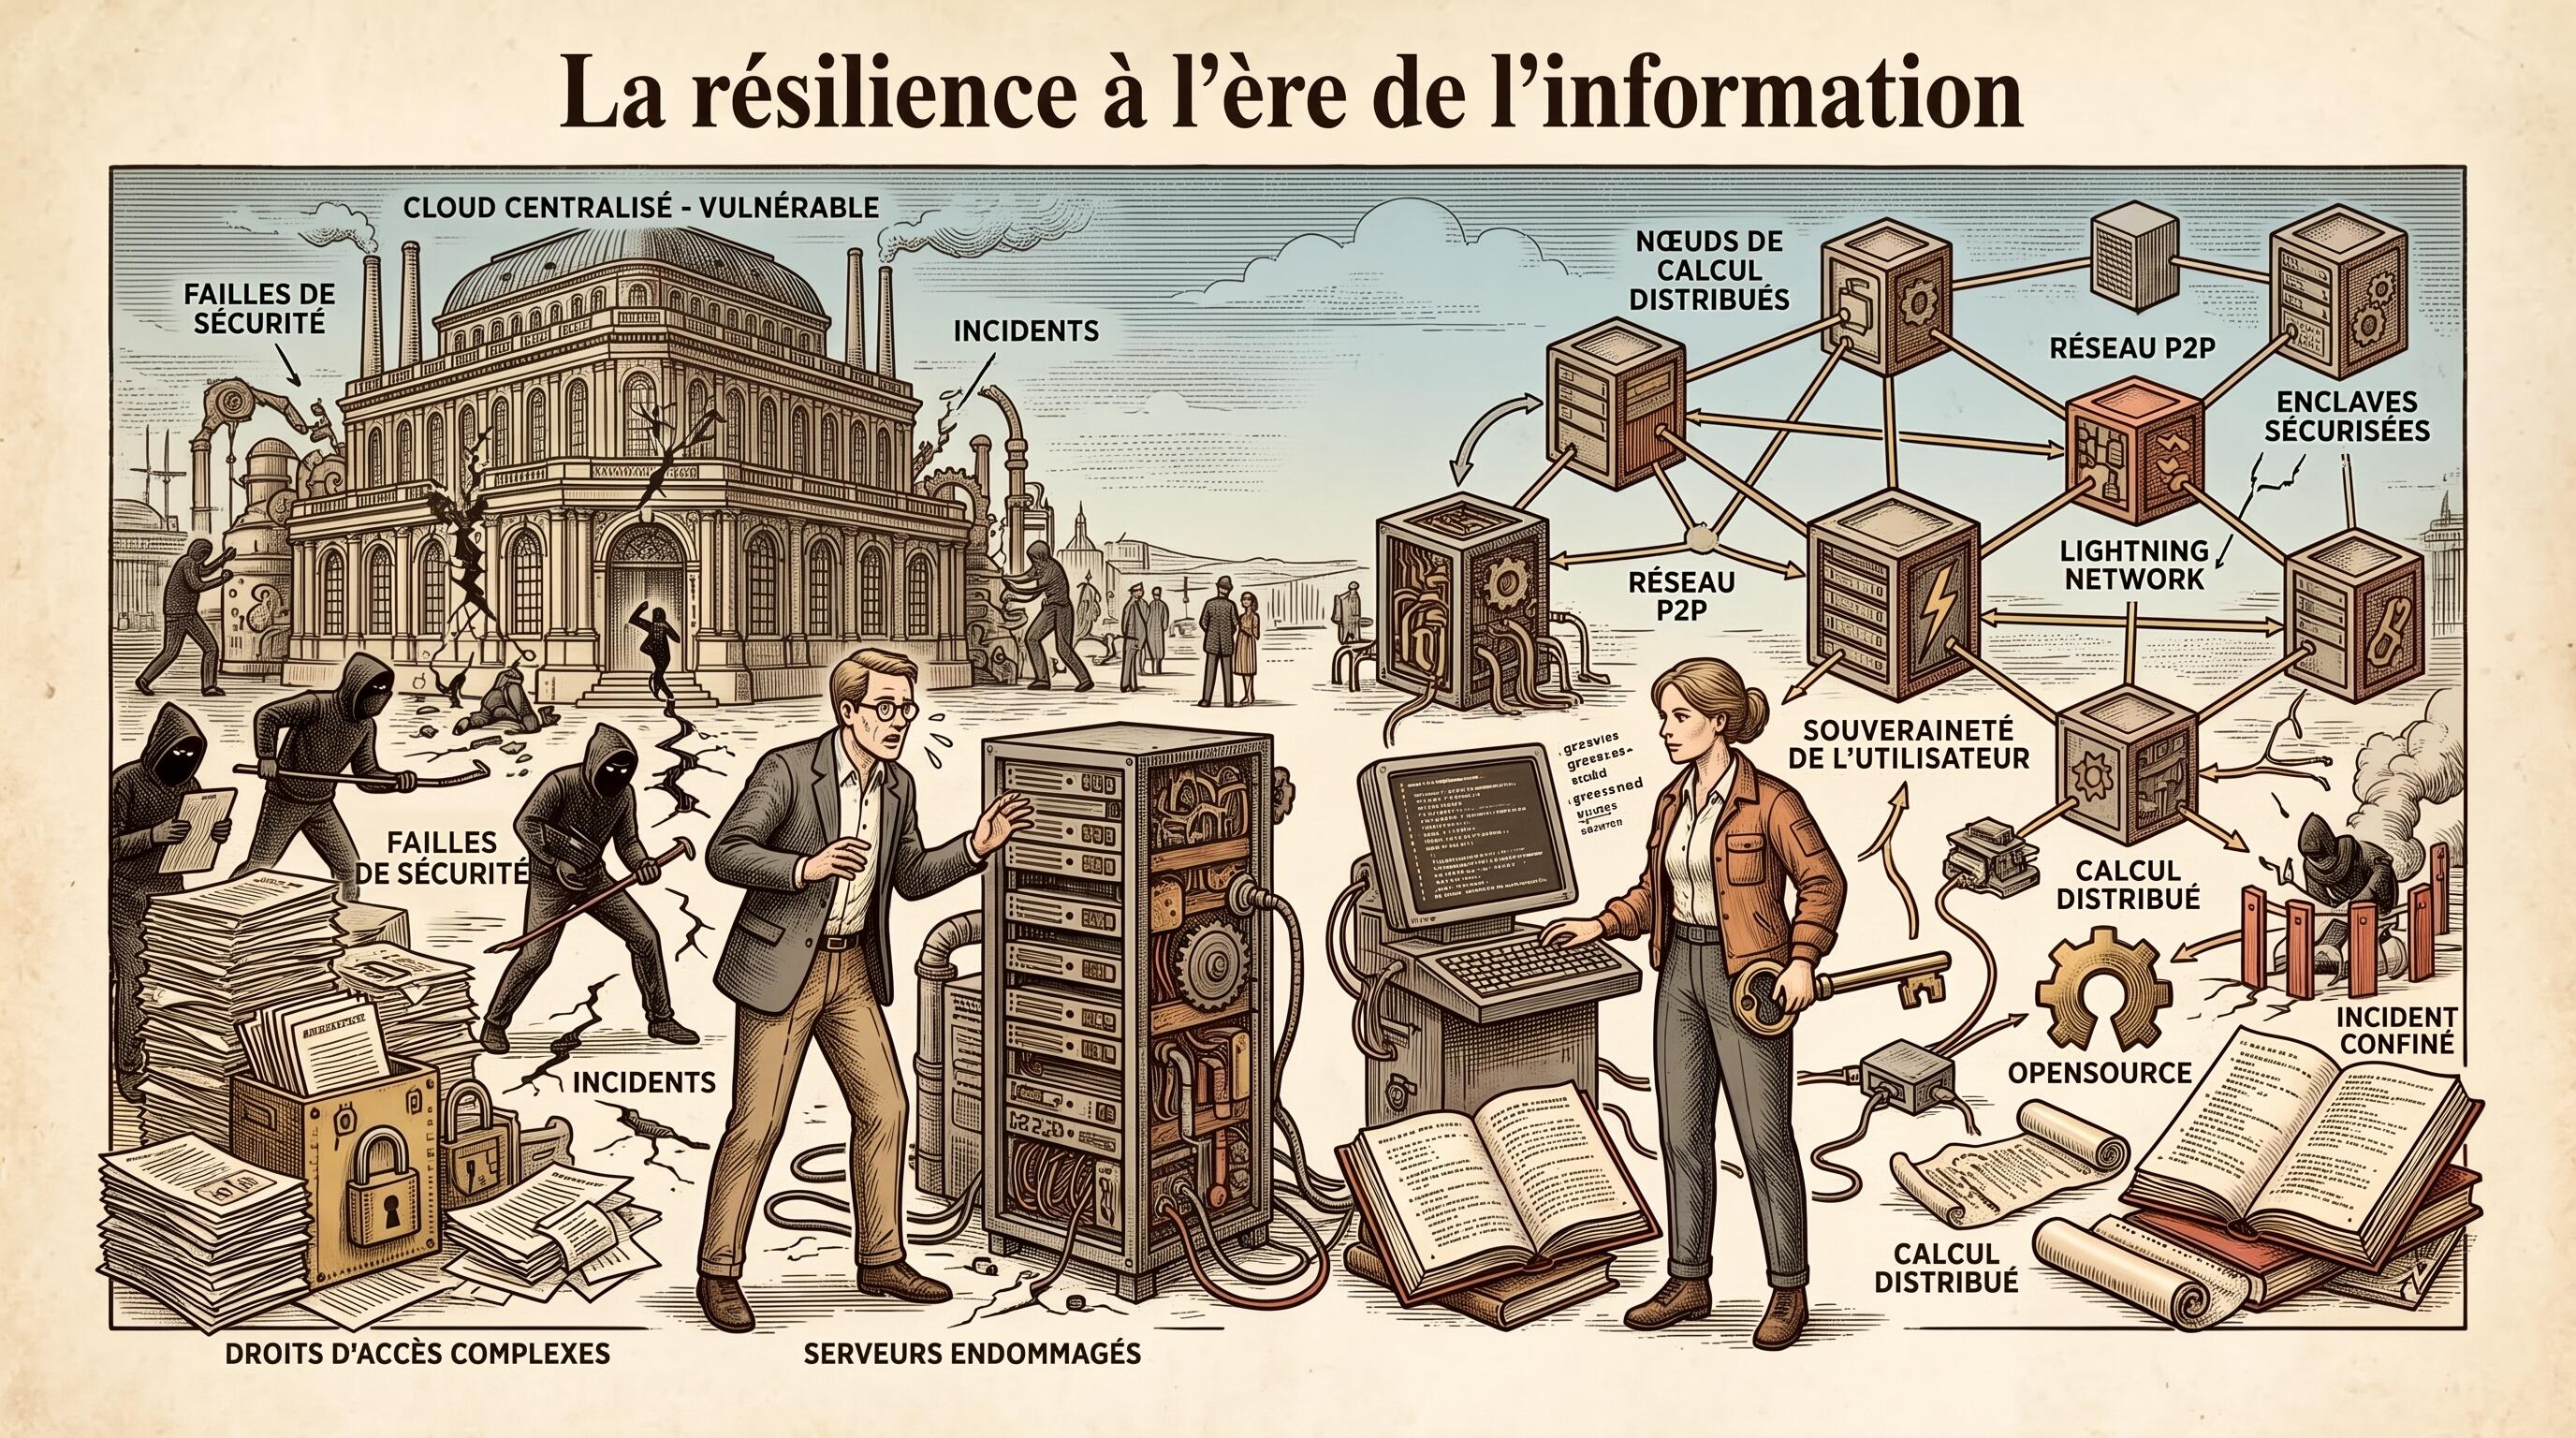
- Assumer la faille
- L’architecture du moindre risque
- Distribuer les traitements
- Les défis des réseaux distribués
- Le coin du voile est levé…
- Ressources
Quand nous voyons toutes les fuites de données qui ont frappé les institutions françaises et certains secteurs privés sensibles depuis le début de l’année, force est de constater que, soit les services informatiques ne sont pas à la hauteur (par laxisme et/ou incompétence), soit parce que les normes appliquées ne sont plus à la hauteur.
Or, un peu d’expérience en cybersécurité permet rapidement de comprendre une chose : les pirates auront toujours un coup d’avance sur les systèmes de sécurité. C’était d’ailleurs le fil rouge ressortant de l’Histoire des codes secrets, de Simon Singh. Dans ce livre particulièrement accessible, Singh nous montre que chaque nouveau code prospère jusqu’à ce qu’une faiblesse soit trouvée, puis il disparaît ou évolue. C’est une véritable « course aux armements intellectuels » qui amène à chaque fois le pirate à rechercher la faille du système, qui forcera ce dernier à évoluer.
Face à ce défi, les systèmes centralisés comme le cloud font reposer sur les épaules de l’entreprise cette lourde responsabilité de garantir l’anonymat des données et la sécurité de ses traitements ; et dans le même temps, elle doit sécuriser ses propres données (code source des applications, données stratégiques, etc.). D’autre part, l’ entreprise doit assurer la continuité d’activité de ses services, et assumer les coûts de l’infrastructure portant ces services.
Assumer la faille
Une approche commune face à ces situations est de supposer qu’une faille finira tôt ou tard par survenir. L’entreprise va alors chercher à cloisonner les environnements et les services au sein même de son organisation. Cela permet d’assurer la résilience du système par le confinement des incidents : une faille localisée n’aura pas de répercussion sur les finances, l’activité en général, ou les données gérées par le reste de l’entreprise.
Cependant, cette logique nous ramène à cette gestion cauchemardesque des droits d’accès au sein de l’entreprise, lorsque celle-ci grandit, que nous avons déjà évoquée : cela nécessite d’orchestrer progressivement de plus en plus de politiques d’accès, des comités de validation finissent tôt ou tard par pointer le bout de leur nez pour garder le contrôle, et des audits d’accès réguliers deviennent une nécessité pour éviter de laisser une porte dérobée (comme par exemple le compte mal sécurisé du collègue parti en congé sabbatique, ou la machine virtuelle de l’ancien collègue qui continue de faire tourner trois scripts perdus dans la masse d’information…).
Heureusement, il existe d’autres moyens de réduire la surface d’attaque, en éliminant tout simplement les sources de failles.
L’architecture du moindre risque
Plutôt que de chercher à maîtriser une complexité croissante avec une bureaucratie des accès, nous pouvons déplacer le problème au niveau de l’architecture même de notre système : la donnée confidentielle la plus sûre est celle que nous ne possédons pas.
Pas de propriété intellectuelle, pas de fuite du code source
Il y a fort longtemps, j’avais exposé mon point de vue sur la notion de propriété privée. Pour notre contexte, nous rappellerons uniquement le point même de cet article : les données finiront tôt ou tard par fuiter. Donc si le code source de notre application est déjà public (hébergé sur un dépôt public), celui-ci ne risque plus d’être victime de fuites.
Bien entendu, cette stratégie nécessite de rester prudent sur d’autres données sensibles, susceptibles de se retrouver sur notre dépôt, telles que les clés d’API ou d’accès aux serveurs, les certificats, ou la configuration de notre infrastructure… Quoique désormais, il est également possible d’instrumenter son infrastructure : grâce à des outils comme Terraform, notre infrastructure peut être pilotée via des scripts, que nous pourrons également placer en opensource…
Cette stratégie soulève un autre défi de taille : autant les sources de notre application que l’infrastructure de notre application se retrouvent exposées à toute personne recherchant les petites failles. Cela nous impose donc de redoubler de rigueur dans la robustesse de notre design et de notre architecture.
La stratégie opensource à son paroxysme
D’ailleurs, les logiciels opensource ont cet avantage qu’ils sont en permanence audités par toute sorte de personnes (et d’IA) se baladant sur GitHub, Gitlab, etc. Ainsi, avoir son code en opensource est souvent perçu comme un gage de robustesse, sur le temps long (à condition bien sûr d’être actif et réactif dans les échanges et les évolutions du produit).
Dans certains cas, proposer notre application en opensource peut apporter un autre atout de taille : lorsque nous définissons des interfaces spécifiques à notre application (la façon dont ses composants vont communiquer), nous pourrons potentiellement voir notre stratégie reprise par d’autres acteurs. Loin d’être un inconvénient, être repris de la sorte peut nous permettre de devenir un standard du marché. C’est ce qui s’est produit avec un organisme nommé Swagger : pour les besoins de leurs interfaces, ils ont défini un format de fichier de description, qu’ils ont publié en opensource. Ce format est devenu avec le temps l’OpenAPI, désormais employé par les grands comptes du Cloud, comme AWS, Google, etc.
Cette stratégie a cependant un revers, car exposer le code de notre application et de notre infrastructure peut signifier un réel sacrifice de valeur. Cela implique bien souvent de capitaliser sur notre façon de servir notre application. C’est par exemple le modèle de Red Hat, dont les sources sont publiques, mais le service aux entreprises (via Red Hat Enterprise Linux) est payant.
L’utilisateur réellement souverain de ses données
L’idée est de faire notre maximum pour que les données de l’utilisateur restent chez l’utilisateur. Nous pourrons donc nous assurer que les clés de chiffrement sont générées chez lui, par exemple dans son navigateur, et protégées via des mécanismes éprouvés comme les « HD Wallet » utilisés par les portefeuilles de crypto : ce mécanisme consiste en une « seed » secrète, une base secrète et suffisamment solide, à partir de laquelle toutes les clés sont générées de façon déterministe. De la sorte, l’utilisateur n’a qu’une clé à retenir (souvent représentée sous la forme de 12 ou 24 mots simples en anglais), à partir de laquelle sont générées toutes les clés nécessaires à son utilisation des services.
Et lorsque ceux-ci nécessitent des clés d’API, plutôt que de générer une clé d’accès unique administrée par l’entreprise, en tant que fournisseur, chaque utilisateur pourrait avoir sa propre clé dérivée de sa seed. De la sorte, nous retrouvons la logique de confinement en cas d’incident : typiquement, si un utilisateur se fait pirater sa clé d’accès, les autres clients ne seraient pas compromis, pas plus que ses autres clés d’accès.
Distribuer les traitements
Une partie du traitement peut également rester en local, sur la machine de l’utilisateur. Ceci fonctionne assez bien pour des besoins légers ou des outils individuels, mais rencontre vite ses limites pour des solutions plus complexes, notamment quand elles mettent en œuvre de la collaboration en temps réel (comme le permettent beaucoup de solutions de traitement de texte, par exemple) : cela ouvre la porte à des problèmes de synchronisation des données entre les différents utilisateurs. Le traitement local atteint également ses limites sur les traitements gourmands en ressource, comme dans le cas des LLM, ces grands modèles de langage nécessitant bien souvent plusieurs cartes graphiques et plusieurs dizaines (voire centaines) de Go de RAM.
Calcul distribué
Pour pallier les limites du traitement local sans mettre en place une infrastructure lourde à maintenir côté entreprise, nous pouvons concevoir un réseau de calcul en pair à pair. Dans ce cas de figure, des partenaires (qui peuvent être les clients eux-mêmes) peuvent mettre à disposition une infrastructure hébergeant une partie de la puissance de calcul nécessaire au traitement contre une rémunération à hauteur de l’apport fourni. Des machines anonymes pourront donc exécuter les traitements (comme l’exécution d’un LLM) sans voir elle-même les données traitées. Cocoon, le projet de Pavel Durov lancé en novembre 2025, en est un exemple typique : ce réseau est constitué de GPU dont les propriétaires reçoivent une récompense en TON, une monnaie crypto qu’ils peuvent ensuite utiliser sur le réseau, contre la puissance de calcul qu’ils mettent à disposition de modèles d’IA pour l’inférence (le traitement des requêtes).
Pour cela, nous pouvons exploiter des technologies d’enclaves sécurisées (une zone isolée, au sein même du processeur, où les données restent chiffrées). Contre une preuve de calcul (comme le résultat du traitement, validé par le client), le partenaire sera alors rémunéré. Et pour assurer l’incitation, nous pourrons utiliser une solution basée sur Bitcoin, plutôt que TON : en plus d’apporter un réseau neutre et décentralisé, dont chaque membre peut être réellement propriétaire de sa monnaie, son modèle déflationniste permet de garantir le capital sur le temps long. Bitcoin pouvant contraindre la performance, nous pourrons également exploiter les capacités d’un réseau off-chain type Lightning : ceux-ci sont généralement optimisés pour préserver l’anonymat et la performance, tout en profitant du réseau de Bitcoin lui-même pour garantir les transactions.
Ces technologies pointues sont particulièrement fascinantes, non seulement pour les défis technologiques, mais aussi pour le fondement philosophique, que nous aurons l’occasion d’explorer par la suite.
Conteneurs éphémères
Nos solutions de traitement distribué permettent également (et même : imposent) de concevoir des environnements d’exécution éphémères, dont la création est entièrement automatisée, et la destruction systématique à la fin du traitement. Ceci réduit de facto les questions d’accès sécurisé aux environnements de production, par exemple en concevant ces environnements pour être isolés le temps du traitement.
Son administration revient en fin de compte à consolider le code « Infrastructure as Code » (ou « IaC » typiquement l’instrumentation du code avec Terraform déjà évoquée plus haut). De la sorte, nous pilotons les déploiements, via des scripts, constituant la source de vérité.
Stockage distribué
Si distribuer les traitements est déjà relativement classique, avec le concept de client lourd, ou ces applications web utilisant le navigateur du client quasiment comme un système complet, le stockage présente à son propre niveau de nombreux défis.
Nous parlions de client exploitant le navigateur web, et c’est là aussi un bon exemple, car désormais, ces navigateurs proposent des solutions de stockage comparable à de petites bases de données. Nous y retrouvons des solution similaires à un cache, avec un stockage par clé / valeur (cette dernière peut même être traitée comme un objet, avec des attributs sous forme de nombres, de chaîne de caractères, de liste,… ce qui ouvre pas mal de perspectives), ou des solutions reprenant des mécaniques proches du SQL, qui permet de travailler sur les relations entre des données potentiellement bien plus complexes.
Le stockage local du navigateur web a cependant une limite majeure : il n’est pas conçu pour être conservé dans le temps. Il est fortement lié à des notions de session, et beaucoup de navigateurs proposent des mécanismes de nettoyage, justement pour des raisons de sécurité (ce stockage peut être facilement corrompu et piraté). De plus, ce stockage est généralement très limité en taille…
Si nous voulons éviter de conserver les données des clients malgré tout, il nous reste la même solution que pour le traitement, au travers de technologies comme IPFS. Ce nom – « Inter Planetary File System » – semble un peu pompeux, mais traduit bien l’ambition, car il se présente bel et bien comme un système de fichier distribué sur un ensemble de nœuds, de la même façon qu’avec le réseau Bitcoin, par exemple. Cependant, l’IPFS soulève de nombreux défis de taille, parmi lesquels les risques de latence (surtout quand le volume de donnée devient conséquent), et l’importance d’avoir de nombreux nœuds disponibles pour assurer la disponibilité des données (un mécanisme d’incitation est nécessaire en complément, comme dans le cas du traitement avec Bitcoin mentionné plus haut).
Le cas du stockage présente un cas limite où éviter au maximum de conserver les données des utilisateurs devient difficile. Le plus simple reste souvent de limiter au maximum le volume de ces données, mais là aussi, cela dépend fortement du type de service rendu par notre application.
Les défis des réseaux distribués
Déporter la responsabilité des données et de leur traitement sur le client (parfois des partenaires) est donc la meilleure solution pour assurer leur sécurité, car ces clients sont de base dépositaires de ces données (i.e. ce sont leurs données déjà de base).
Mais nous l’avons vu, le stockage, et même les traitements lourds – comme l’entraînement de modèles d’IA – les solutions distribuées peuvent atteindre leurs limites, et la meilleure solution sera finalement un hybride entre solutions centralisés (sur le cloud) et solutions distribuées.
Ces solutions soulèvent également un enjeu auquel j’ai déjà été confronté en débutant sur Linux : comprendre et maîtriser les outils peut être difficile à appréhender, pour le grand public.
Car même pour conserver ses clés de chiffrement (comme nous conservons les clés de notre appartement ou de notre voiture), sans s’en remettre à un tiers de confiance nécessite de maîtriser les concepts de cryptographie. De la génération de ces clés à leur stockage, j’ai déjà vu des failles de sécurité sur des systèmes dont la complexité la met encore hors de portée du néophyte.
Je pense d’ailleurs que la cryptographie fait partie de ces domaines devant être intégrés au cursus scolaire et mis à la portée des plus jeunes (via vulgarisation), afin de permettre à n’importe qui de maîtriser ses clés, ou à minima d’être en mesure de comprendre comment ça marche, et juger les solutions offertes sur le marché.
Le coin du voile est levé…
Nous voici donc avec un article plus pointu que d’usage : mettre en place une architecture à la fois résiliente face à la charge et face aux menaces soulève de nombreux défis techniques de taille.
Elle implique également pour l’entreprise d’accepter de lâcher du lest sur sa propriété intellectuelle, ce qui n’est pas toujours évident pour les grandes entreprises, car une bonne partie de leur stratégie repose sur le secret professionnel.
Les données clientes constituent également un grand défi qu’il est possible de surmonter techniquement, mais au final, cela revient à déplacer le défi : les clients doivent disposer soit d’interfaces particulièrement didactiques et ergonomiques, soit d’une solide culture technique, surtout pour lever tout problème de confiances qu’entraînent la dépendance à des outils que nous ne maîtrisons pas.
Les solutions techniques sont très pointues et sont de vrais sujets d’études à part entière que nous pourrons explorer au travers d’articles dédiés à la souveraineté des utilisateurs. Nous pourrons également explorer de nombreuses ressources de vulgarisation très sympathiques, comme le livre de Simon Singh !
Ressources
- L’Histoire des codes secrets, de Simon Singh.
- Cocoon by Pavel Durov, a decentralized confidential computing network that could redefine AI, de Tort Mario.
- Pavel Duro unveils Cocoon Network on TON for AI, sur atomicwallet.
- Débuter avec Bitcoin, sur bitcoin.org.
Write a comment